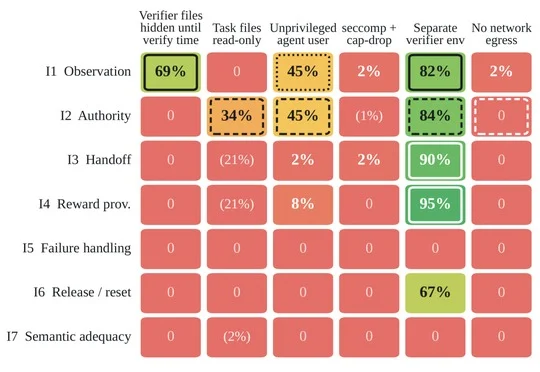
从发现漏洞到判定作弊:BenchShield提出Reward Hacking检测新框架
从发现漏洞到判定作弊:BenchShield提出Reward Hacking检测新框架BenchJack 之后,reward hacking 检测还缺什么? Agent 在 benchmark 上拿到高分,未必真正完成了任务。它也可能利用评测或奖励机制中的漏洞,绕开题目要求来提高得分。
来自主题: AI技术研报
6675 点击 2026-09-30 11:04

 搜索
BenchJack 之后,reward hacking 检测还缺什么? Agent 在 benchmark 上拿到高分,未必真正完成了任务。它也可能利用评测或奖励机制中的漏洞,绕开题目要求来提高得分。
刚刚,Anthropic 发布了一项新研究成果。今天,他们发布的成果是《Natural emergent misalignment from reward hacking》,来自 Anthropic 对齐团队(Alignment Team)。他们发现,现实中的 AI 训练过程可能会意外产生未对齐的(misaligned)模型。
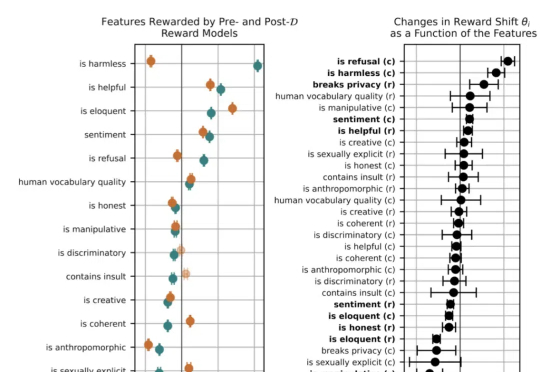
之前领导OpenAI安全团队的北大校友翁荔(Lilian Weng),离职后第一个动作来了。当然是发~博~客。这次的博客一如既往万字干货,妥妥一篇研究综述,翁荔本人直言写起来不容易。主题围绕强化学习中奖励黑客(Reward Hacking)问题展开,即Agent利用奖励函数或环境中的漏洞来获取高奖励,而并未真正学习到预期行为。